

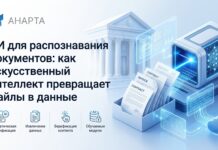


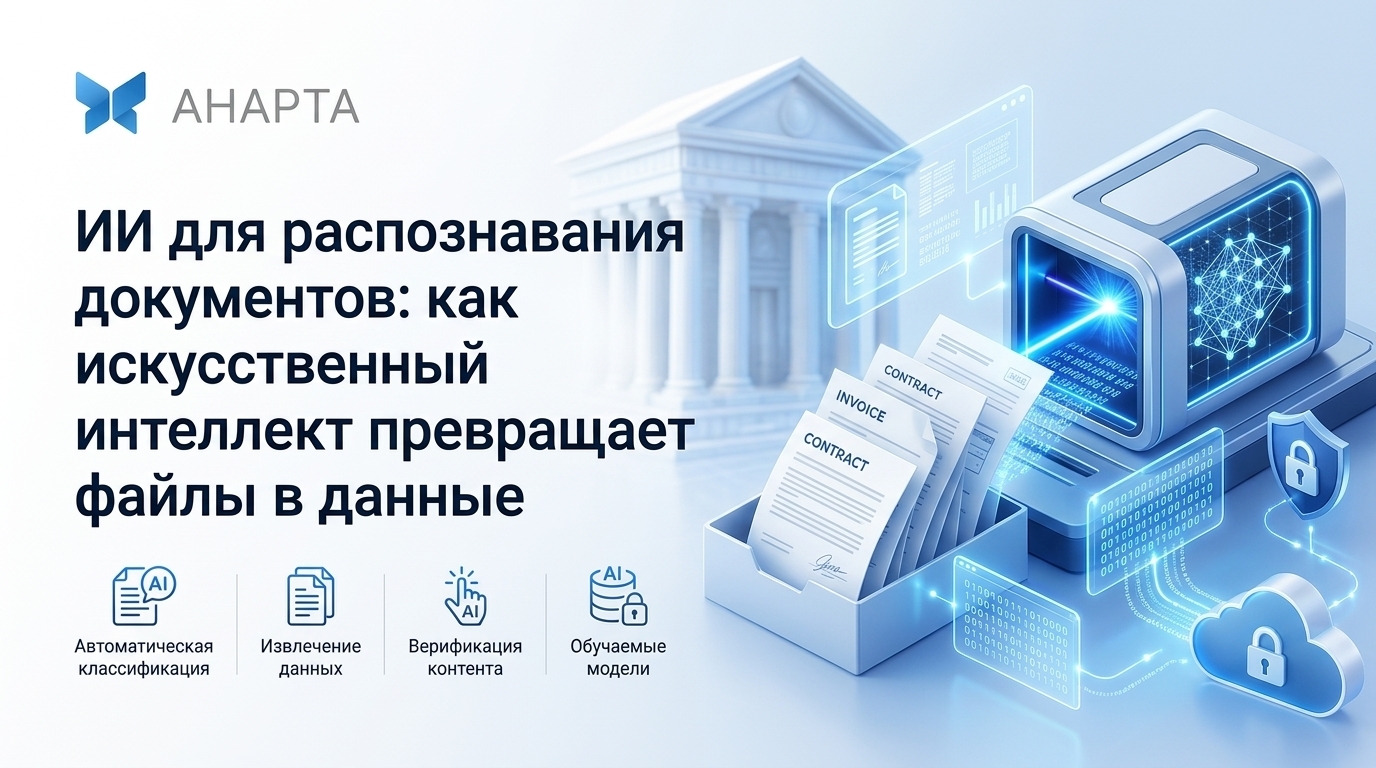
Бумажный документооборот умирает: обработка традиционных документов затратна и не исключает ошибки из-за человеческого фактора. В то же время повсеместное внедрение инструментов ИИ позволяет распознать документы сравнительно небольшой ценой и перейти к намного более эффективному документообороту.
Генеральный директор компании «Анарта» Александр Алексеев рассказывает, как современный искусственный интеллект используется для извлечения и классификации, анализа и маршрутизации входного потока документов, и как это позволяет высвободить ресурсы компании и уменьшить риски формальных ошибок.
Что такое ИИ для распознавания документов
Это система на основе искусственного интеллекта, которая позволяет извлекать информацию из документов большинства существующих типов и анализировать их по заданным параметрам. Однако ИИ не только оцифровывает файлы, но производит сложные и многоплановые действия, освобождая человека от рутинной работы. Об этом и поговорим ниже.
Чем AI OCR и IDP отличаются от классического OCR
Классические системы оптического распознавания символов OCR (Optical Character Recognition) анализируют изображение отсканированного документа, распознают на изображении текстовые символы и постепенно переводят весь документ в текстовый вид, пригодный для редактирования.
Базовые OCR-системы появились еще 30 лет назад, но появление ИИ изменило все. За счет обучения на большом корпусе данных, нейросеть способна распознать то, что классические системы не в состоянии обработать.
AI OCR превосходит базовую систему по следующим параметрам:
● распознает сканы низкого качества, снятые под углом, с размытыми фрагментами;
● понимает рукописный текст, сложную комбинацию шрифтов;
● легко разбирается в многоязычных документах;
● правит формальные ошибки и опечатки;
● соблюдает структуру исходного текста, включая стили, таблицы, выравнивание, а также правильно передает диаграммы, рисунки, подписи и т.д.
IDP (Intelligent Document Processing) — следующий за распознаванием шаг, когда нейросеть выполняет интеллектуальную обработку извлеченных данных.
Возможности систем интеллектуальной обработки документов на основе IDP:
● классификация представленных материалов — система сама понимает, что это за документ (акт, протокол, счет, удостоверение и др.);
● извлечение данных из документа и передача их в другой документ или в приложение для обработки;
● анализ данных, поиск ошибок, расхождений, несоответствий;
● правильная обработка неструктурированных документов;
● работа по цепочке: то есть по результату распознавания создаются последующие документы, решающие ту или иную задачу.
Проще говоря, AI OCR читает текст с использованием нейросети, а IDP понимает оцифрованный документ с учетом контекста.
Как работает искусственный интеллект в распознавании документов
Существует точная последовательность подключения различных технологических систем для комплексного решения задач распознавания.
Основные этапы в распознавании:
● предварительная обработка и повышение качества исходных сканов и файлов, в том числе сглаживание механических повреждений документа, удаление бликования, повышение контрастности. Работают нейросети компьютерного зрения;
● анализ структуры: разбивка на сегменты, определение функционального назначения выделенных фрагментов. Задачу выполняют сверхточные нейросети и трансформеры, обученные на реальных документах;
● распознавание, за которое отвечает AI OCR, то есть перевод картинки (скана) в машинный текст;
● исправление ошибок написания символов. Используются словари и языковые NLP-модели;
● классификация (отнесение документа к определенному типу) и извлечение полей;
● оценка корректности данных. Все та же нейросеть оценивает осмысленность полученных значений именно в контексте той сферы, в которой используется документ. Например, полученные в результате OCR цифры могут фактически распознаться верно, но из-за ошибки быть больше, чем реально возможные, на порядок. ИИ отловит такой случай и исправит;
● создание связанных данных на основе выстроенных бизнес процессов, подключение RPA‑роботов для постановки задач на основе распознанных данных.
Наш эксперт Александр Алексеев из компании «Анарта» отдельно подчеркивает, что все перечисленные задачи выполняются в контуре заказчика без передачи данных во внешние сервисы. Риск утечки персональных сведений исключен полностью. Именно таким образом работает решение по распознаванию и оцифровке документов с помощью ИИ, которое предлагает компания «Анарта».
А какие именно документы можно распознать?
Какие документы можно распознавать с помощью ИИ
На самом деле — практически любые. С использованием нейросетей можно обрабатывать структурированные и имеющие свободную форму документы.
Основные форматы документов:
● личные и идентификационные: паспорт внутренний и загран, водительские права, СНиЛС, ИНН, дипломы и свидетельства, то есть все персональные бумаги государственного образца;
● правовые: доверенности, договора, протоколы, решения, постановления;
● финансовые и платежные: счета, накладные, ордера, выписки, чеки;
● кадровые: приказы по структуре, трудовые договоры и книжки, карточки сотрудников, выписки СФР;
● архивные: массивы информации, исторические документы, техрегламенты, патенты;
● медицинские: карты пациента, рецепты, результаты исследований;
● технические, графика: сметы, чертежи, ТУ и ГОСТы, спецификации, графики;
● рукописные материалы: письма, служебные записки, анкеты, отчеты с обязательным применением интеллектуального распознавания символов ICR.
Следует учитывать, что стандартные формы обрабатываются системой быстрее и точнее, чем рукописные материалы. В последнем случае может потребоваться ручная проверка корректности или автоматическая валидация на финальном этапе распознавания.
Какие данные извлекает ИИ из документов
Формат и параметры извлекаемых данных зависят от поставленной задачи.
Что именно извлекает ИИ в исходниках разных типов:
● текстовые материалы различных форматов, с выполнением форматирования (заголовки, поля отступа, шрифт) ;
● таблицы, графики, диаграммы, другую информацию, которую необходимо привести к табличной форме;
● реквизиты, подписи, печати, даты и другие формальные данные из исходника;
● с учетом семантики и контекста задачи выделяются даты, суммы, наименования, имена и определяются связи между ними.
Следует учитывать: если система AI OCR получила конкретный запрос, то она игнорирует ненужные для ответа поля. Например, если запрос касается итоговой суммы к конкретной дате сверки, то остальные данные ИИ не учтет.
Возможности ИИ-систем для распознавания документов
Исходные материалы можно разделить на несколько профильных групп:
● изображения (сканы и фото, в том числе с телефона), самым распространенным является JPG/JPEG формат;
● PDF, включая текстовый, сканированный и гибридный;
● рукописные, обрабатываются с помощью ICR (Intelligent Character Recognition);
● комбинированные, например, скан документа с рукописным визированием поверх печатного текста;
● нестандартные, не имеющие жесткой привязки к тому или иному формату.
Распознавание с помощью искусственного интеллекта имеет важную особенность: оно не строится на выборе шаблона. ИИ в состоянии адаптироваться к любому мыслимому документу и вычленить из него важную информацию.
Другими словами ИИ узнает платежное поручение вне зависимости от его формата, верстки, качества сканирования, шрифтов и других характеристик. Если модель имеет достаточную базу обучения, то она сможет распознать практически что угодно.
В практике компании «Анарта» есть кейсы с распознаванием формализованных и неформализованных документов с весьма нестандартными форматами. ИИ справляется.
Зачем бизнесу распознавание документов с помощью ИИ
Хорошо. С возможностями мы разобрались. Давайте теперь посмотрим на выгоды бизнеса. Основные выгоды от внедрения ИИ-системы таковы:
● сокращение рутинных операций и высвобождение времени сотрудников для более сложных работ, требующих участия человека;
● минимизация недочетов из-за человеческого фактора;
● активный ИИ-поиск по документам организации и быстрый доступ к документации;
● интеграция в действующие на предприятии CRM-системы;
● уменьшение сроков подачи отчетности, минимизация возвратов отчетов на доработку и исправление.
Экономический эффект от внедрения современной системы заметен сразу, период ожидания отсутствует.
Где применяется ИИ для распознавания документов
Особенно полезно применять нейросети в следующих направлениях:
● бухгалтерия и финансирование, ЭДО;
● кредитный процессинг и скоринг;
● торговля, реализация, коммерческие предложения;
● кадровые задачи и HR;
● юридическое сопровождение;
● закупки и тендеры.
При первичном анализе входного файла выполняется автоматическая классификация и отнесение исследуемого объекта к конкретной нише. Затем извлекаются значимые элементы и выполняется поставленная задача.
Требования к системе распознавания документов
- Точность. Ключевая характеристика, без которой распознавание документов перестает быть надежным. ИИ-модель должна обеспечивать высокую точность распознавания. Конкретные цифры зависят от отрасли и специфики документов.
- Скорость. Необходимо справляться с потоками различной интенсивности, затраты на обработку единицы информации должны составлять несколько секунд. Смена типа входного файла не должна требовать длительной перенастройки системы.
- Безопасность. Данные не должны выходить за пределы компании, а к локальному процессингу доступ может иметь ограниченный круг ответственных лиц. Контроль и фиксация доступа к системе обязательны. Отдельно отметим комплаенс, т.е. соответствие решения федеральным законам (152-ФЗ, 125-ФЗ и других), а также внутренним стандартам организации.
- Интеграции. Бесшовная работа в комплексе с другими системами документооборота и отчетности, оперативная передача готовых результатов в 1С и другие учетные программы.
- API. Интуитивно понятный программный интерфейс ускорит работу персонала с ИИ-системой, для чего должны быть созданы инструкции и утвержден регламент работ.
- Исключение потери информации. На всех этапах обработки останавливается полный запрет на обращение к внешним серверам. Обязательно использование шифрования и ведение журналов доступа.
Как выбрать решение для распознавания документов на базе ИИ
Выбирая конкретное решение, в первую очередь необходимо сопоставить приемлемую технологию, сферы деятельности компании и существующую инфраструктуру.
Базовым фильтром для выбора служит определение типа обрабатываемых данных, поскольку не все системы одинаково ровно работают с нужными форматами. Обязательно следует учесть: формализованы или нет исходные материалы, как часто будут встречаться сложные элементы или специфические форматы, какой язык будет задействован и допустим ли смешанный текст.
На что еще обратить внимание при выборе:
● доступность адаптации выбранной модели. Стоит определить, есть ли возможность дообучения системы, какие для этого предусмотрены встроенные инструменты, кто будет донастраивать и сколько информации потребуется ввести для адаптации пакета к требованиям заказчика;
● стоимость владения, куда входит цена пакета и аппаратные требования, услуги вендора по настройке и адаптации, при масштабировании потока информации;
● процедура внедрения, от чего зависит реальный успех проекта. Потребуется учесть обучение персонала, интеграцию с учетными системами, сроки окончания пробного периода и начало полномасштабного использования.
Нельзя забывать и о сопровождении внедренного проекта. Формат поддержки выбирается при подписании договора на передачу системы. Должны быть предусмотрены регулярные обновления, а пользователю передан полный комплект документации.
Ошибки на этапе внедрения
Типичные ошибки при внедрении нейросетей для документооборота могут свести на нет реальные преимущества технологии.
Давайте коротко обозначим важные моменты, на которые следует обратить внимание при работе с нейро-агентами по документообороту:
● низкое качество входных данных для обучения требует увеличения продолжительности обучения. В противном случае качество распознавания упадет;
● выбор технологии распознавания должен обеспечить качественный уровень обработки с учетом решаемых задач бизнеса;
● пилотное тестирование обязательно для выявления критических неувязок;
● нельзя игнорировать вопросы безопасности и защиты персональных данных;
● интеграция решения в действующие учетные системы — это такая же часть реализации проекта, как и все остальные. Пренебрегать ею нельзя;
● последнее по списку, но не последнее по важности — все критичные и чувствительные решения после ИИ должен проверять человек.
Если вы заинтересованы во внедрении ИИ в документооборот компании для автоматизации распознавания бухгалтерских, юридических, идентификационных или иных документов, обращайтесь в компанию «Анарта».